GPT-6 Sol és Luna magyarul: az OpenAI felezte az árakat

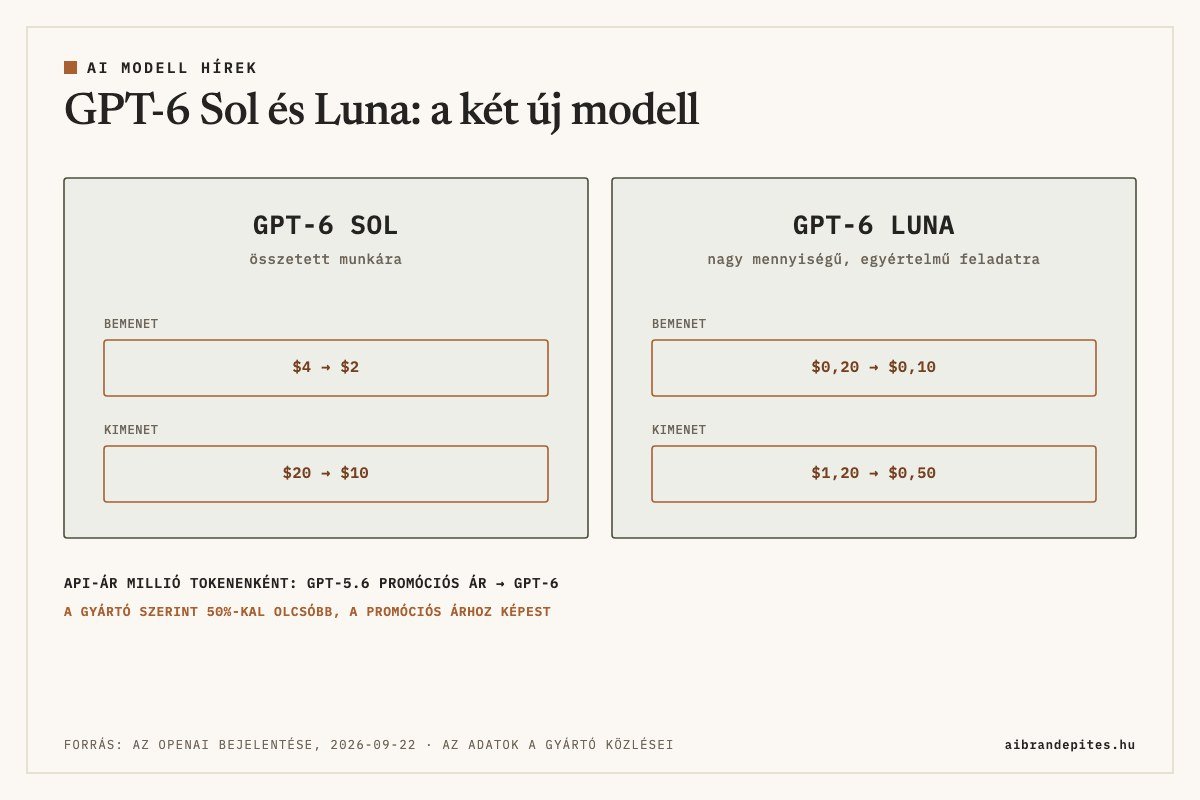
Egymillió kimeneti token a GPT-6 Solnál 10 dollárba kerül, az elődjénél promóciós áron még 20 dollár volt. Az OpenAI 2026. szeptember 22-én mutatta be a GPT-6 Solt és a GPT-6 Lunát, és a saját közlése szerint mindkettőt 50 százalékkal olcsóbban kínálja a GPT-5.6-os elődök promóciós áránál. Az árak mellett a gyorsítótárazás és a modellek kommunikációs stílusa is változott.
- A GPT-6 Sol az összetett munkára, a GPT-6 Luna a nagy mennyiségű, egyértelmű célú feladatokra készült.
- Továbbra is a GPT-6 Astra az OpenAI legjobb modellje, a közlemény szerint.
- A gyártó szerint az API-árak a GPT-5.6 promóciós árához képest 50 százalékkal csökkentek.
- A gyorsítótárból olvasott bemeneti tokenekre 90 százalékos kedvezmény jár.
- Minden szám a gyártó saját bejelentéséből és méréséből származik.
Két új szereplő a palettán
Az OpenAI kínálatában a GPT-6 Astra maradt a csúcs, a közlemény szerint minden területen ez a cég legjobb modellje. Mellé érkezett két új modell, amelyek olcsóbban dolgoznak, és egy-egy feladattípusra vannak szabva:
- GPT-6 Sol: összetett munkára
- GPT-6 Luna: nagy mennyiségű, egyértelmű célú feladatra
A hír súlya két dologban van: a csökkentett árakban és a gyorsítótárazás fejlesztésében. Ha az Astráról is olvasnál, a GPT-6 Astráról szóló cikkünkben megtalálod, mit tud a cég csúcsmodellje.
Mi a Sol és mi a Luna
Az Astra ugyanebben a hónapban, de korábban jelent meg. Ha a lehető legjobb eredmény a cél, a közlemény szerint azt érdemes választani.
A GPT-6 Sol az összetett munkára való. Mellette a GPT-6 Luna a nagy mennyiségű, egyértelmű célú feladatokra készült. A közlemény ezeket a példákat említi:
- dokumentum-összefoglalás
- adatkinyerés
- gyors kérdések
Mindkét új modellt hasonló módszerrel tanították, mint az Astrát. Ha nem vagy biztos benne, melyiket válaszd, gondold végig, mennyire összetett a feladat, és milyen gyakran kell elvégezni. Az API-ban a gpt-6-sol és a gpt-6-luna azonosítóval hívhatod őket.
Az árak: felezés, és ami mögötte van
A közlemény táblázata egymillió tokenre, dollárban adja meg az árakat. Összehasonlításként mellé tettük a GPT-5.6-os elődök promóciós árát:
| Modell | Bemenet | Kimenet |
|---|---|---|
| GPT-5.6 Sol (promóciós ár) | 4 dollár | 20 dollár |
| GPT-6 Sol | 2 dollár | 10 dollár |
| GPT-5.6 Luna (promóciós ár) | 0,20 dollár | 1,20 dollár |
| GPT-6 Luna | 0,10 dollár | 0,50 dollár |
A bemenet az a szöveg, amelyet elküldesz a modellnek, a kimenet pedig a válasz, amelyet visszakapsz. A gyorsítótárból olvasott bemeneti tokenekre 90 százalékos kedvezmény jár. Ha tehát ugyanazt a hosszú szöveget többször elküldöd, az ismételt részért jóval kevesebbet fizetsz.
Indoklásként a közlemény a gyorsítótárazás és a futtatás hatékonyságának javulását hozza fel. Mindkét modellnél, a Solnál és a Lunánál is 50 százalékos árcsökkentést tüntet fel, a GPT-5.6 promóciós árához képest.
Teljesítmény és költségek a tesztek alapján
A gyártó több teszten mérte a két modellt, és a feladatonkénti költséget is feltüntette. Minden alábbi szám az OpenAI saját bejelentéséből származik. A közlemény megjegyzi, hogy a méréseket kutatási környezetben vagy az API-n keresztül végezték, ezért az eredmények kissé eltérhetnek attól, amit a ChatGPT-ben tapasztalsz.
Az eredmények mellett zárójelben feltüntetjük a közleményben szereplő erőfeszítési szintet is (low, közepes, high, xhigh, max).
AutomationBench 1.0.6: üzleti munkafolyamatokat mér 47 eszközzel, az értékesítés, a marketing, az üzemeltetés, az ügyfélszolgálat, a pénzügy és a HR területén. A pontszámok és a költségek a közlemény szerint:
| Modell (erőfeszítés) | Pontszám | Költség |
|---|---|---|
| GPT-6 Sol (xhigh) | 33,2 | 0,27 dollár feladatonként |
| GPT-6 Astra (low) | 30,3 | a Sol költségének 3,9-szerese |
| Claude Fable 5.1 Opus 5 tartalékkal (max) | 31,4 | a Sol költségének több mint 8,9-szerese |
| Claude Opus 5 (max) | 26,9 | a Sol költségének 11,1-szerese |
Ugyanezen a teszten a GPT-6 Luna high erőfeszítésen 5,4 százalékponttal jobb az elődjénél, feladatonként 58 százalékkal olcsóbban. A közlemény megjegyzi, hogy a Claude Fable 5.1 adatpontja alábecsli a tényleges költséget, mert kimaradnak belőle az Opus 5 tartalék-hívásai, amelyekre a feladatok nagyjából 40 százalékán sor került.
Agents' Last Exam V1: összetett szakmai munkafolyamatokat mér 55 alágazatban. A GPT-6 Sol max erőfeszítésen 56,4 pontot ért el, ami a közlemény szerint a Claude Opus 5 legjobb eredménye fölött van, feladatonként 60 százalékkal olcsóbban.
DeepSWE 1.1: összetett szoftverfejlesztési feladatokat mér valódi kódbázisokon. Az eredmények:
- GPT-6 Sol (max): 68,8 pont, 1,1 százalékponton belül a Claude Fable 5 legjobb eredményétől (69,9 pont, xhigh), feladatonként nagyjából 80 százalékkal olcsóbban
- GPT-6 Luna (max): 66,6 pont, a Claude Opus 5 és a Fable 5 közepes erőfeszítésű eredményével mérhető össze, feladatonként 93 százalékkal olcsóbban az Opus 5-nél és 96 százalékkal a Fable 5-nél
FrontierCode 1.1 Main: a kódot a helyesség mellett beolvaszthatóságra is pontozza, vagyis nézi a tesztek minőségét, a hatókör-fegyelmet és a kódstílust. A GPT-6 Sol a közlemény szerint érdemben jobb a GPT-5.6 Solnál, és jóval alacsonyabb költségen eléri a Claude Fable 5.1 xhigh eredményét. Konkrét pontszámot ehhez a teszthez a bejelentés nem közölt.
OSWorld 2.0 offline: számítógép-használatot mér, a v2026.08.08 kiadás offline halmazán. Az eredmények:
- GPT-6 Sol (xhigh): 60,5 pont, feladatonként nagyjából 80 százalékkal olcsóbban a Claude Opus 5-nél
- Claude Opus 5 (közepes): 60,3 pont
- GPT-6 Luna (max): meghaladja a GPT-5.6 Sol közepes erőfeszítésű eredményét, annak tizedéért
Számítógép-használatban a közlemény szerint a GPT-6 Astra marad a legjobb modell.
Kevesebb tárgyi tévedés
Az OpenAI belső tényszerűség-mérése valódi beszélgetéseken alapul, amelyeket személyazonosításra alkalmatlanná tettek. Olyan beszélgetésekről van szó, amelyekben a felhasználók hibát jeleztek egy korábbi modellnél.
Mindkét modell javult ezen a mérésen a közlemény szerint:
- GPT-6 Sol: nagyjából feleannyi hibát vét, mint az elődje, és jóval alacsonyabb költségen megközelíti az Astra megbízhatóságát
- GPT-6 Luna: magasabb erőfeszítési szinteken a GPT-5.6 Sol szintjét hozza, annak nagyjából századáért
A közlemény hozzáteszi, hogy a hibára kihegyezett beszélgetések eltérnek a tipikus használattól, amelyben a tárgyi tévedés ritkább.
Illeszkedés (alignment) terén is javult a Sol és a Luna a GPT-5.6-os megfelelőjéhez képest. Többek között ritkábban állítanak félrevezető dolgokat a saját kódolási munkájukról. A közlemény szerint ezek a mérések szándékosan nehéz helyzeteket tesztelnek.
Más lett a hangja is
Az Astra javított kommunikációs stílusa átkerült a Solba és a Lunába. A közlemény szerint ez a technikai és kódolási beszélgetésekben lesz a legfeltűnőbb, és így mutatkozik meg:
- több világosság
- kevesebb szakzsargon és kevesebb furcsa fordulat
- összességében kicsit rövidebb válaszok, a tartalom elvesztése nélkül
- kevesebb alacsony értékű részlet
Ha a ChatGPT-t kódolásra vagy technikai kérdésekre használod, itt veheted észre leghamarabb a különbséget. Érdemes egy korábbi, hosszúra nyúlt beszélgetésedet újra feltenni, és összevetni a két választ.
Fejlesztőknek: a gyorsítótár lett a nagy nyereség
A GPT-6 prompt-gyorsítótárazása alapból magasabb találati arányt ad, és a gyorsítótárból olvasott bemeneti tokenekre 90 százalékos kedvezmény jár. A közlemény ezeket a változásokat sorolja fel:
- Prompt Caching Dashboard a gyorsítótárazás mérésére
- diagnosztikai eszköz, amely megmagyarázza a kihagyott lehetőségeket
- a gondolkodási erőfeszítés és az eszközök ki-be kapcsolása már nem töri el a gyorsítótárat
- kifejezett töréspontokkal (breakpoint) megadható, hol ér véget a gyorsítótárazott prompt-előtag
Töréspontokkal elválaszthatod a prompt állandó részét a változó adatoktól, így az állandó rész a gyorsítótárból jöhet. A GitHub jelentése szerint ezek a javítások az elmúlt hónapokban több mint 50 százalékkal csökkentették a friss feldolgozást igénylő prompt-tokenek arányát, több milliárd kérésen.
Hol éred el
A két modell a bejelentés napjától több helyen elérhető, a csomagodtól függően:
- ChatGPT Work és Codex: a Plus, Pro, Business, Enterprise és Edu felhasználóknak
- asztali alkalmazás: az ingyenes és a Go csomag felhasználói a GPT-6 Lunát érik el
- API: gpt-6-sol és gpt-6-luna néven
- Chat felület: egyik modell sem elérhető még
A bevezetés a nap folyamán fokozatosan történt. Ha a ChatGPT Workben vagy a Codexben még nem látod az új modelleket, a közlemény szerint később érdemes újra próbálkozni.
Mit tegyél most
Csomagtól és szereptől függően mást érdemes most kipróbálni:
- Plus, Pro, Business, Enterprise vagy Edu csomaggal: a Solt és a Lunát a ChatGPT Workben és a Codexben
- ingyenes vagy Go csomaggal: a Lunát az asztali alkalmazásban
- fejlesztőként: a töréspontokat és a Prompt Caching Dashboardot, hogy kihasználd a 90 százalékos gyorsítótár-kedvezményt
Ha sok dokumentumot foglalsz össze vagy adatot nyersz ki, a Luna pontosan erre a feladattípusra készült. Érdemes egy-két valódi dokumentumon kipróbálni, mielőtt rábízod a rendszeres munkát. Kész promptokat a 25 kész ChatGPT-promptot tartalmazó gyűjteményünkben is találsz hozzá.
Fejlesztőként a saját jellemző kéréseiden vesd össze az új és a régi modell költségét és eredményét.
Gyakran ismételt kérdések
Mennyivel lett olcsóbb a GPT-6 Sol?
A bemeneti ára 4 dollárról 2 dollárra, a kimeneti 20 dollárról 10 dollárra csökkent egymillió tokenre. A közlemény ezt 50 százalékos csökkentésként tünteti fel, a GPT-5.6 Sol promóciós árához képest.
Mi a különbség a Sol és a Luna között?
A GPT-6 Sol az összetett munkára készült. A GPT-6 Luna a nagy mennyiségű, egyértelmű célú feladatokra, például dokumentum-összefoglalásra, adatkinyerésre és gyors kérdésekre.
Elérhető-e ingyenes ChatGPT-fiókkal?
Az ingyenes és a Go csomag felhasználói a GPT-6 Lunát érik el, az asztali alkalmazásban. A Chat felületen a bejelentéskor egyik új modell sem volt elérhető.
Jobb-e a Sol a Claude modelleknél?
A gyártó saját mérése szerint az Agents' Last Exam teszten a Sol a Claude Opus 5 legjobb eredménye fölött van, feladatonként 60 százalékkal olcsóbban. DeepSWE teszten pedig 1,1 százalékponton belül van a Claude Fable 5 legjobb eredményétől. A versenytársak pontszámait az OpenAI nyilvánosan elérhető jelentésekből vette át.
Elérhető-e a Chat felületen?
A közlemény szerint a bejelentéskor a Chat felületen még egyik új modell sem volt elérhető. A ChatGPT Workben, a Codexben, az asztali alkalmazásban és az API-n már el lehet érni őket, a csomagodtól függően.


Tetszett a cikk?
Iratkozz fel és kapd meg a legfrissebb cikkeket közvetlenül az email fiókodba. Napi hírlevél a legfontosabb AI és tech hírekről, magyarul, 5 perc alatt átfutható formában.